Growth OS
Un equipo de IA de crecimiento que encuentra lo que cuesta dinero, consigue el visto bueno de quien corresponde y actúa.
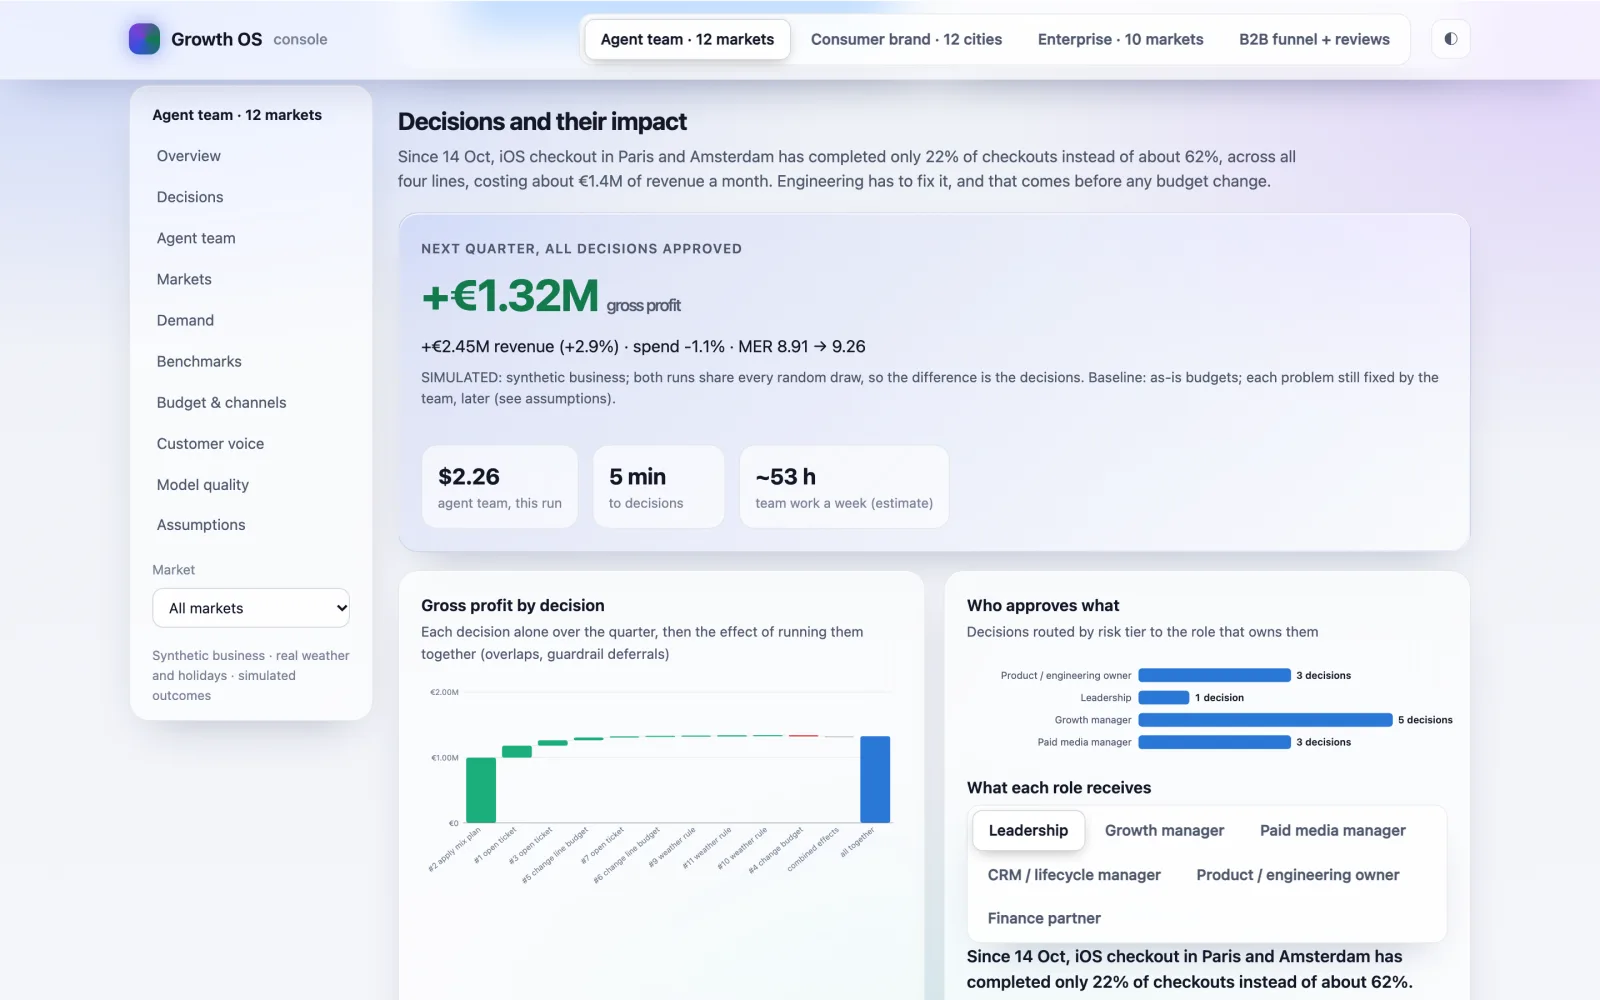
Resumen
Un equipo de agentes de IA que hace la parte de la semana de un equipo de crecimiento que los dashboards dejan a las personas: ver qué cambió y por qué, decidir, conseguir la aprobación de quien corresponde, hacer el cambio y comprobar si funcionó. Construido y probado sobre una marca de consumo sintética con 12 mercados, 4 líneas de producto y unos 3,3 M€ de marketing al mes, con tiempo meteorológico y festivos reales.
De un vistazo
- 37 · 35 · 39comprobaciones de 45 en tres negocios que ninguno había visto: el equipo de agentes, una sola llamada a Claude con la salida de todas las herramientas y una lista de reglas sin IA. Las opciones más simples igualan al equipoEvaluación con datos no vistos
- 0acciones sin la aprobación de una persona. Verificación de roles, doble firma en cambios de riesgo, topes de presupuesto, interruptor de parada, registro y marcha atrásPor diseño
- +3,9 %margen bruto tras marketing el próximo trimestre en el negocio de demostración, con todas las decisiones aprobadas, gastando un 1,1 % menos (ingresos +2,9 %)Simulado · negocio sintético de 3,3 M€ al mes
- 8,91 → 9,26MER: ingresos por cada euro de marketingSimulado
- 5 min · 2,26 $por ejecución semanal completa: seis agentes, 99 llamadas a herramientas, 12 decisiones enviadas a cinco rolesMedido
- 41/45comprobaciones del equipo según una persona, frente a 37 según el evaluador de IA: coinciden en el 82 % de ellasRevisión del evaluador
Cómo leer estas cifras
La lectura más justa es la evaluación con datos no vistos: tres negocios que los agentes nunca habían visto, con sus problemas colocados en otros mercados, líneas y dispositivos. Allí el equipo superó 37 de 45 comprobaciones y ganó entre un +2,7 % y un +4,6 % de margen bruto. Después vino la prueba que casi ninguna demo de agentes hace: los mismos negocios, el mismo evaluador y el mismo trimestre simulado para dos opciones más simples. Lo hicieron igual de bien. Las puntuaciones se midieron mientras esas tres semillas eran privadas; al publicar el código pasan a ser públicas, así que la próxima evaluación usará semillas nuevas.
El negocio de demostración es el de la consola. Sus problemas se colocaron a propósito, así que su +3,9 % (+1,32 M€ de margen bruto en el trimestre) es un techo para un negocio construido para contenerlos. Como referencia: esa ganancia equivale al 13,8 % del gasto en marketing del trimestre.
¿Gana el equipo a opciones más simples? Simulado
Tres opciones sobre los mismos tres negocios no vistos, puntuadas por el mismo evaluador de IA en una sola pasada y valoradas con el mismo trimestre simulado.
| Opción | Comprobaciones · margen bruto próximo trimestre · coste del modelo por semana |
|---|---|
| Equipo de agentes: un responsable y cuatro especialistas que eligen sus herramientas | 37/45 · +2,7 %, +4,6 %, +3,9 % · unos 2,50 $ |
| Una sola llamada a Claude, con la salida de todas las herramientas de entrada | 35/45 · +3,4 %, +4,2 %, +4,4 % · unos 1,90 $ |
| Lista de reglas, sin IA | 39/45 · +3,4 %, +4,2 %, +3,9 % · 0 $ |
No. Los motores probados (estadística, benchmarks, el modelo de marketing mix) y el catálogo de acciones son comunes a las tres opciones, y hacen la mayor parte del trabajo: con su salida sobre la mesa, una sola llamada bien instruida encuentra casi lo mismo que un equipo. La lista de reglas es una referencia exigente, no ingenua, porque su autor sabía qué tipos de problema coloca el generador. Lo que esta prueba no puede medir es un problema que nadie había previsto, que es donde el criterio sobre las mismas herramientas tiene que justificar su coste. Esa es la próxima prueba.
El problema
Los equipos de crecimiento grandes ya tienen el data warehouse y los dashboards. Lo que se come su semana es todo lo que viene después del dashboard. Con 12 mercados, 4 líneas de producto, 8 canales de pago más orgánico, email y SMS, hay demasiadas combinaciones para revisarlas a mano: la cola larga nunca se mira, los presupuestos repiten el reparto del trimestre anterior y cada plataforma cuenta su propia versión.
La dirección pregunta “¿vamos según el plan, dónde se nos escapa el dinero, qué necesita mi firma?” y recibe la respuesta tarde, en una presentación. Los managers pasan el lunes cuadrando cifras en lugar de decidir. Los equipos de automatización ven cada decisión convertirse en una cadena manual: exportar, analizar, escribir, aprobar, cambiar la plataforma, acordarse de comprobar. Nada queda registrado de principio a fin, y nada es reversible por diseño.
La idea: no construir otro dashboard, sino el equipo que lo trabaja. Encuentra el problema, lo cuantifica en dinero, propone una acción concreta, consigue que la apruebe la persona adecuada, la ejecuta y la mide.
Un equipo de agentes, una tarea cada uno
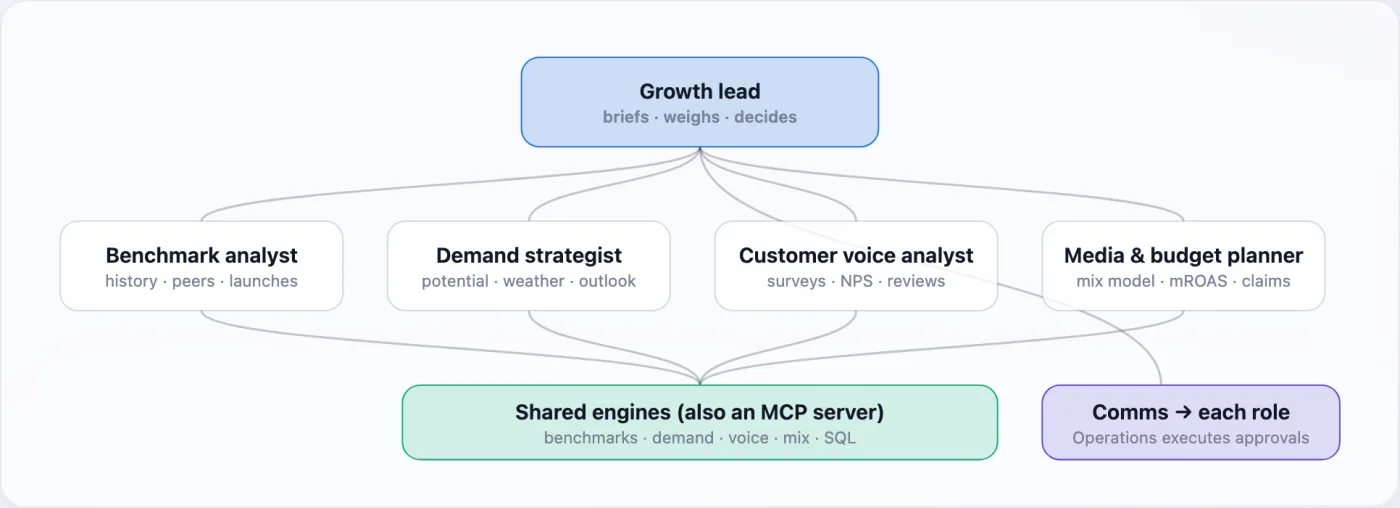
Seis agentes de Claude con roles dedicados comparten un mismo conjunto de motores probados. Esos motores se sirven también como servidor MCP, así que un manager puede hacer desde Claude las mismas preguntas que hacen los agentes.
- Analista de benchmarks. Compara cada mercado con sus mismas semanas del año anterior, con mercados de perfil parecido y con aperturas anteriores a la misma edad, e informa de lo que está fuera de lo normal, y de lo que solo lo parece.
- Estratega de demanda. Estima cuánta demanda tiene cada mercado y línea (interés de búsqueda de la categoría, perfil del mercado, tiempo y festivos reales), cuánta capta la marca y qué harán los próximos 14 días de previsión meteorológica.
- Analista de la voz del cliente. Lee respuestas de encuestas, comentarios NPS, reseñas y tickets de soporte en seis idiomas, etiquetados por Claude Haiku, y encuentra temas inusualmente frecuentes en un mercado, como entregas tardías o pagos fallidos.
- Planificador de medios y presupuesto. Usa un modelo de marketing mix ajustado sobre 60 semanas de cambios de presupuesto para encontrar canales saturados, canales que sobre todo recogen compradores que vendrían igual, y dónde rinde más el siguiente euro.
- Responsable de crecimiento. Da instrucciones a los cuatro especialistas en paralelo, une sus hallazgos, descarta el ruido y lo estacional, y decide. Cada recomendación es una acción ejecutable con el dinero en juego, el rol que debe aprobarla y una métrica para comprobarla después.
- Comunicación interna. Escribe un mensaje breve por rol (dirección, growth manager, medios de pago, CRM, producto, finanzas): qué cambió para ellos y qué tienen que decidir.
- Operaciones. Reglas, no un modelo. Solo ejecuta lo aprobado, con el rol del aprobador verificado, una segunda persona para los cambios de riesgo, topes de presupuesto, interruptor de parada, registro y marcha atrás.
Decisiones de diseño clave
Dónde está el criterio.
Acciones, no conclusiones.
Cada recomendación nombra una acción de un catálogo fijo (mover presupuesto entre canales, cambiar el presupuesto de una línea, una regla por lluvia, pausar un canal, un ticket para ingeniería, operaciones o SEO, un test A/B, un mensaje a un rol) con un destino real. Si nombra un mercado o canal que no existe, vuelve al agente.
Cada problema va a quien puede arreglarlo.
Un fallo de pago en un dispositivo va a ingeniería como ticket con la evidencia, no a marketing como un recorte de presupuesto. Las entregas tardías van a logística.
La aprobación se enruta por riesgo.
Los cambios de bajo riesgo los aprueba el responsable del canal, los movimientos de presupuesto el growth manager, y los cambios de toda la cartera o las subidas grandes la dirección, con aviso a finanzas. Se comprueba quién tiene realmente cada rol.
Medido contra una referencia honesta.
Sin el sistema, el equipo arregla igualmente cada problema, solo que más tarde: un fallo de pago a los 10 días, las entregas a los 21, una caída del tráfico de búsqueda a los 35. A los agentes solo se les acredita actuar antes y decidir mejor el presupuesto.
Una prueba que no se puede memorizar.
Cada negocio de prueba coloca sus 12 problemas en mercados, líneas y dispositivos distintos, así que los negocios de evaluación son realmente nuevos. Las instrucciones no nombran ninguna respuesta.
Motores deterministas, IA para el criterio.
La estadística es código con tests: los mismos números siempre. Los agentes deciden qué mirar, unen evidencias de fuentes distintas, juzgan qué es ruido y lo explican. Entre el 96 % y el 98 % de las cifras de sus decisiones salen de resultados de las herramientas. La comparación con opciones más simples muestra dónde está el peso: en los motores.
Cómo es un trimestre Simulado
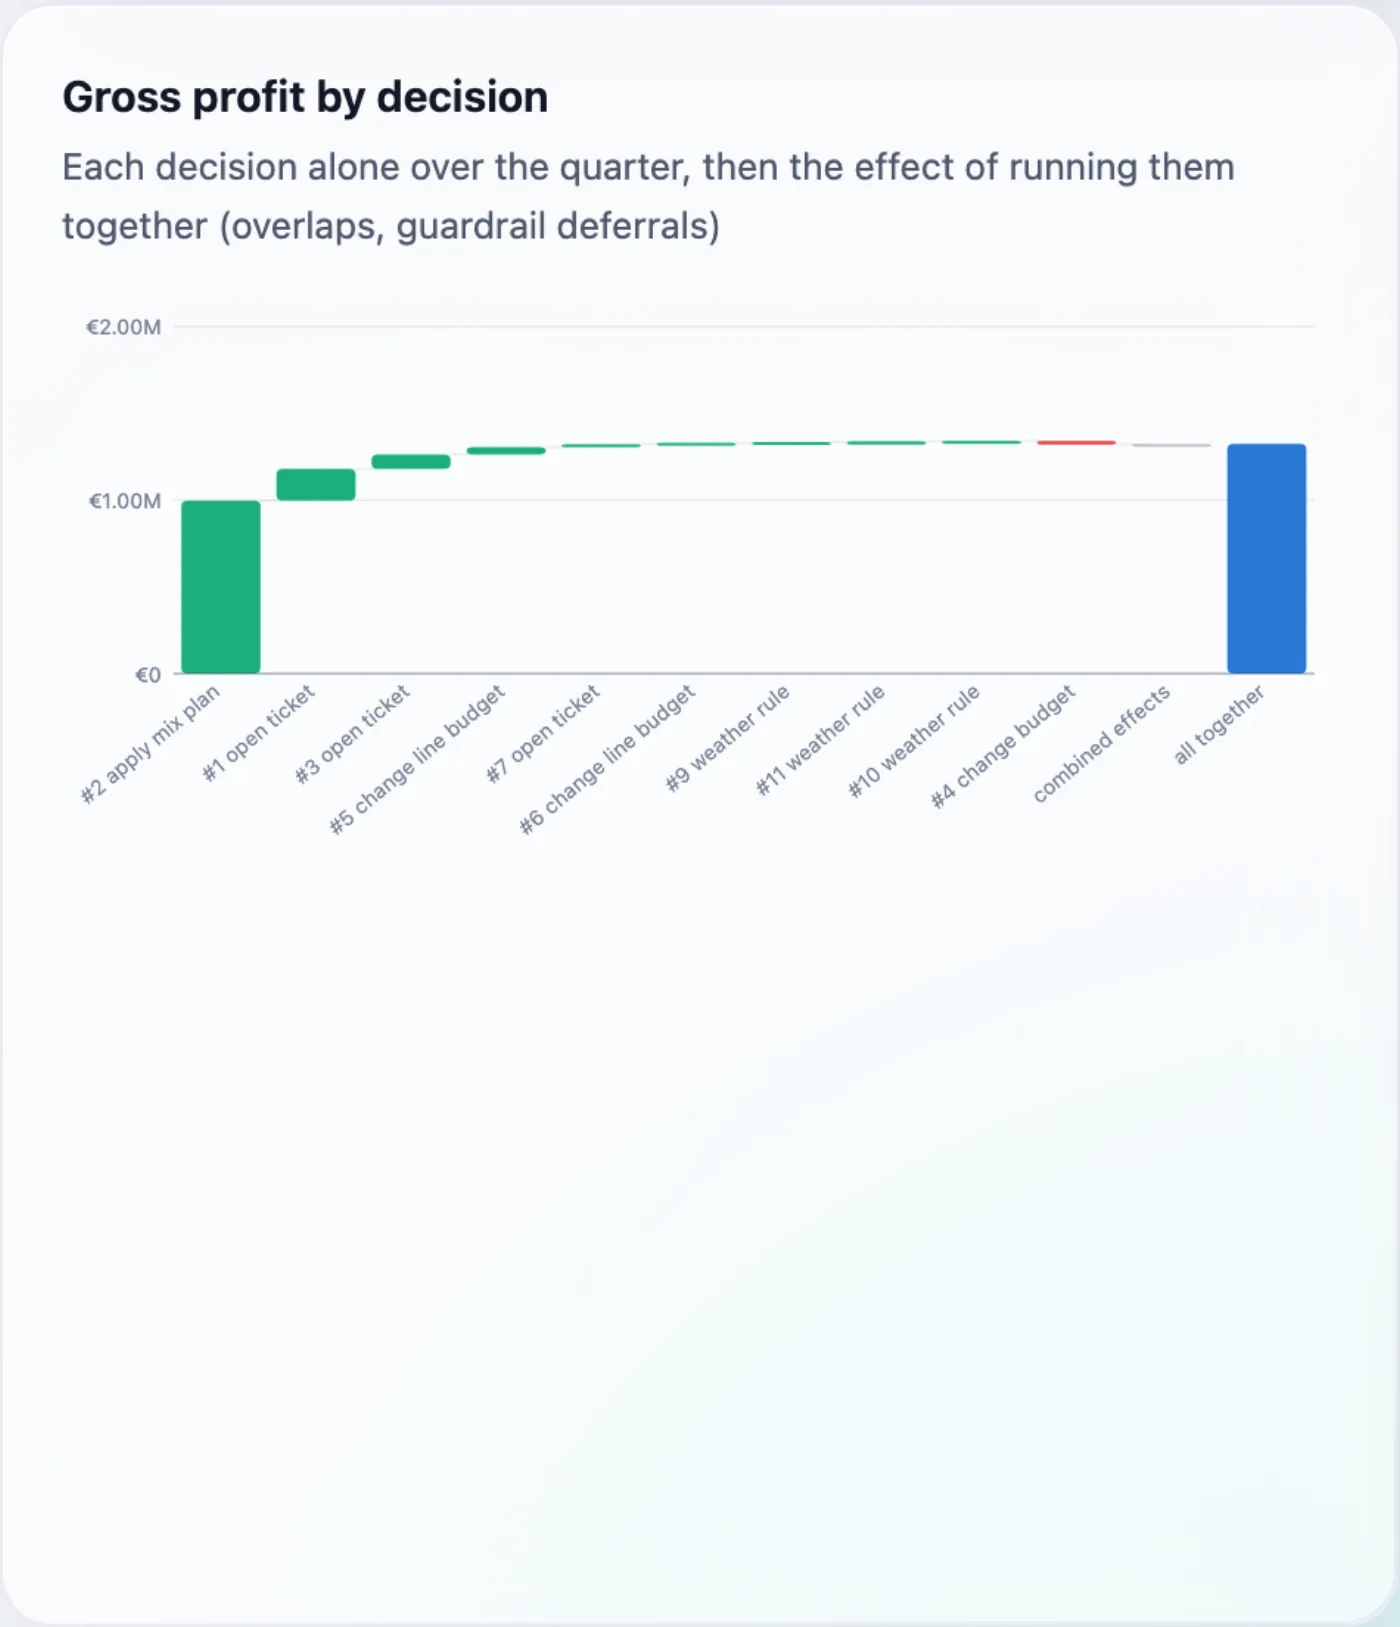
Una ejecución semanal sobre el negocio sintético produjo 12 decisiones. Cada una se proyectó 13 semanas dos veces desde el mismo día y con las mismas tiradas aleatorias: una aprobada y otra no. La diferencia es lo que valía la decisión.
La mayor ganancia vino de aplicar el reparto por canal del modelo de marketing mix en toda la cartera, aprobado por la dirección: más a TikTok, YouTube, creadores y búsqueda genérica, menos a los canales saturados, sin mover ningún canal más allá de su tope. Un fallo de pago en iOS en dos ciudades se detectó y fue a ingeniería. Una caída del tráfico de búsqueda tras un cambio en la web fue a SEO. Se movió presupuesto hacia el mercado y la línea que menos demanda potencial captaban, y tres reglas por lluvia siguieron la sensibilidad meteorológica medida.
El próximo trimestre con todas las decisiones aprobadas Simulado
| Ingresos | +2,9 % |
|---|---|
| Margen bruto tras marketing | +3,9 % |
| Gasto en marketing | −1,1 % |
| MER (ingresos ÷ marketing) | 8,91 → 9,26 |
| Coste de adquisición de cliente | −4,2 % |
| Negocios no vistos, margen bruto | +2,7 %, +4,6 %, +3,9 % |
En un negocio real la misma comparación necesita un grupo de control. El sistema lo planifica: qué mercados apagan un canal, durante cuántas semanas y el cambio más pequeño que podría detectar.
Tú decides, el trimestre cambia Simulado
La consola abre con las 12 decisiones de la IA en tarjetas, cada una con el rol responsable y el dinero que vale por sí sola. Aprueba o rechaza cualquiera y el trimestre se recalcula. Cuando tu elección coincide con una ejecución que se simuló de verdad (todo aprobado, todo rechazado, una decisión fuera, una decisión sola) ves esa ejecución. Cualquier otra combinación se muestra como suma de ejecuciones sueltas, marcada con «≈», porque las decisiones se influyen entre sí.
Hay una tarjeta que conviene rechazar. Devolver Londres a su presupuesto pierde unos 21.000 € de margen bruto por sí sola, y la ejecución que la deja fuera del plan de la IA gana 20.141 € más que aprobarlo todo. Para eso está el paso de aprobación: el sistema no acierta siempre, así que decide una persona.
Una decisión, de la señal al registro Simulado
El problema más grande que encontró el equipo, seguido paso a paso. Las etiquetas indican de dónde sale cada cifra: «enlazado» significa que aparece en un resultado devuelto por una herramienta de los agentes; «sin rastrear», que no se pudo comprobar.
- Señal. El analista de benchmarks revisó la tasa de conversión de checkout a pedido en iOS en todos los mercados. París estaba en el 34,8 % en 28 días frente a un rango de mercados similares del 61,7 % al 62,4 %, y Ámsterdam igual de lejos. enlazado
- Razonamiento. El responsable de crecimiento escribió (traducido): «El 14 de octubre la tasa de éxito del checkout en iOS cayó del 62 % al 22 % en ambos mercados y en todas las líneas. Otros dispositivos y otros mercados no se vieron afectados, y las quejas por pagos se multiplicaron por cinco a la vez». enlazado
- Dinero en juego. Unos 1,4 M€ de ingresos al mes: 976.000 € en París y 428.000 € en Ámsterdam. enlazado sin rastrear
- Responsable. No es un problema de marketing, así que no se toca el presupuesto: un ticket de bajo riesgo para ingeniería, enviado al responsable de producto, con la evidencia adjunta (pedidos, checkouts, la ventana de despliegue a revisar, marcha atrás si hace falta).
- Aprobación y ejecución. Aprobado por el responsable de producto. La línea del registro del ejecutor: «ejecutado · ticket para ingeniería».
- Resultado. +182.653 € de margen bruto y +362.266 € de ingresos en el trimestre solo por esta decisión, frente a un equipo que arregla el fallo a los 10 días en vez de a los 3.
El piloto en vivo
Real, no simulado
Growth OS también funciona con el embudo y la cuenta de anuncios de Meta de un pequeño estudio web, desde el 30 de octubre de 2026. Allí el ejecutor solo puede pausar o reactivar anuncios, y solo después de que una persona lo apruebe.
De momento ningún anuncio ha cumplido una regla, así que no se ha pausado ni reactivado nada. Los resultados se añadirán aquí cuando haya algo real que enseñar, por pequeño que sea.
Los motores, en la consola
Cada vista se construye con los datos al generar la página. Pasa el ratón por cualquier marca para ver sus cifras.
- Demanda: cuota captada de la demanda potencial por mercado y línea; efecto de la lluvia en los pedidos con rangos al 95 % a partir del tiempo real; la lluvia prevista en los próximos 14 días por ciudad.
- Benchmarks: cada mercado frente al rango de sus pares y su propio año anterior, en tasa de pago por dispositivo, MER, cuota orgánica y cuota de clientes recurrentes.
- Presupuesto: ROAS marginal por mercado y canal, curvas de respuesta por canal, cuota de gasto frente a cuota de ingresos, y lo que declara cada plataforma frente a los ingresos propios.
- Voz del cliente: temas de queja por mercado en 11.024 comentarios, etiquetados por unos dos céntimos.
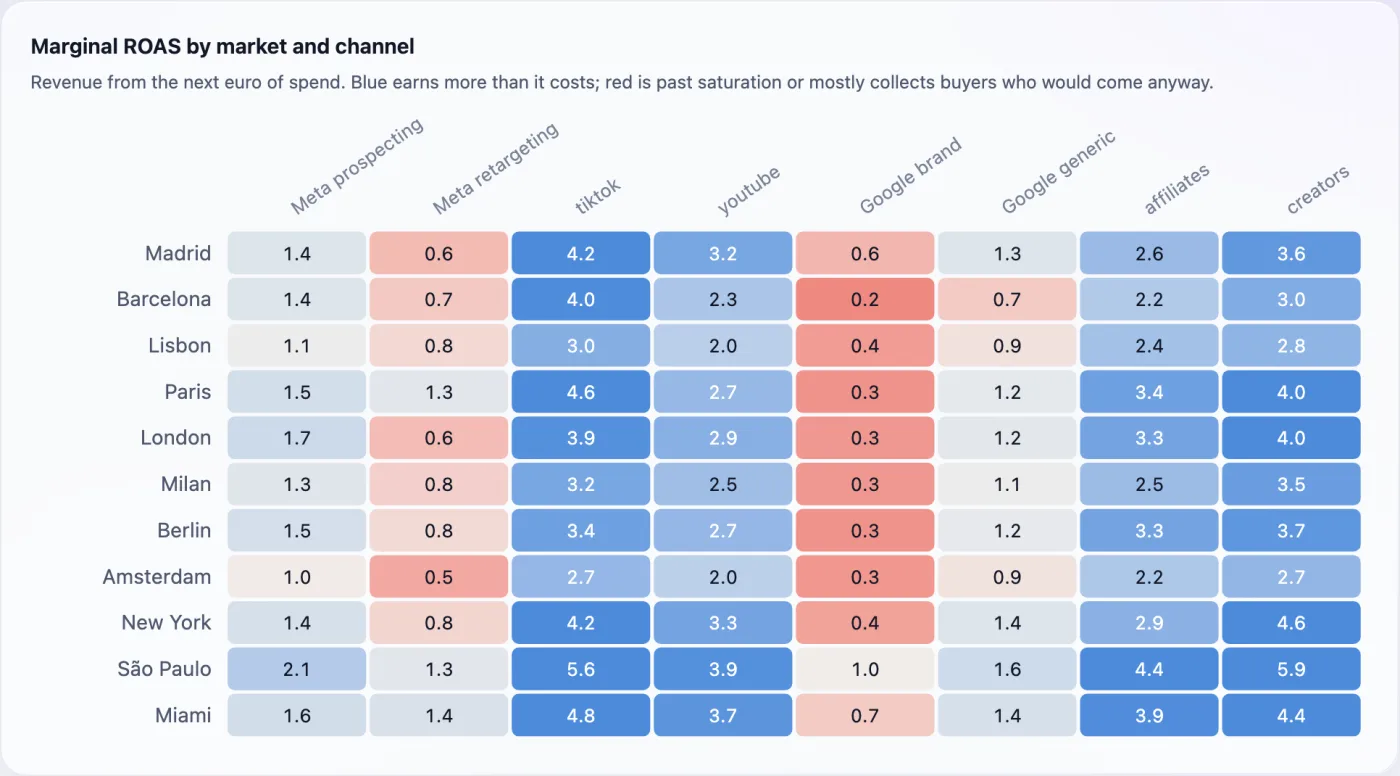
Vistas
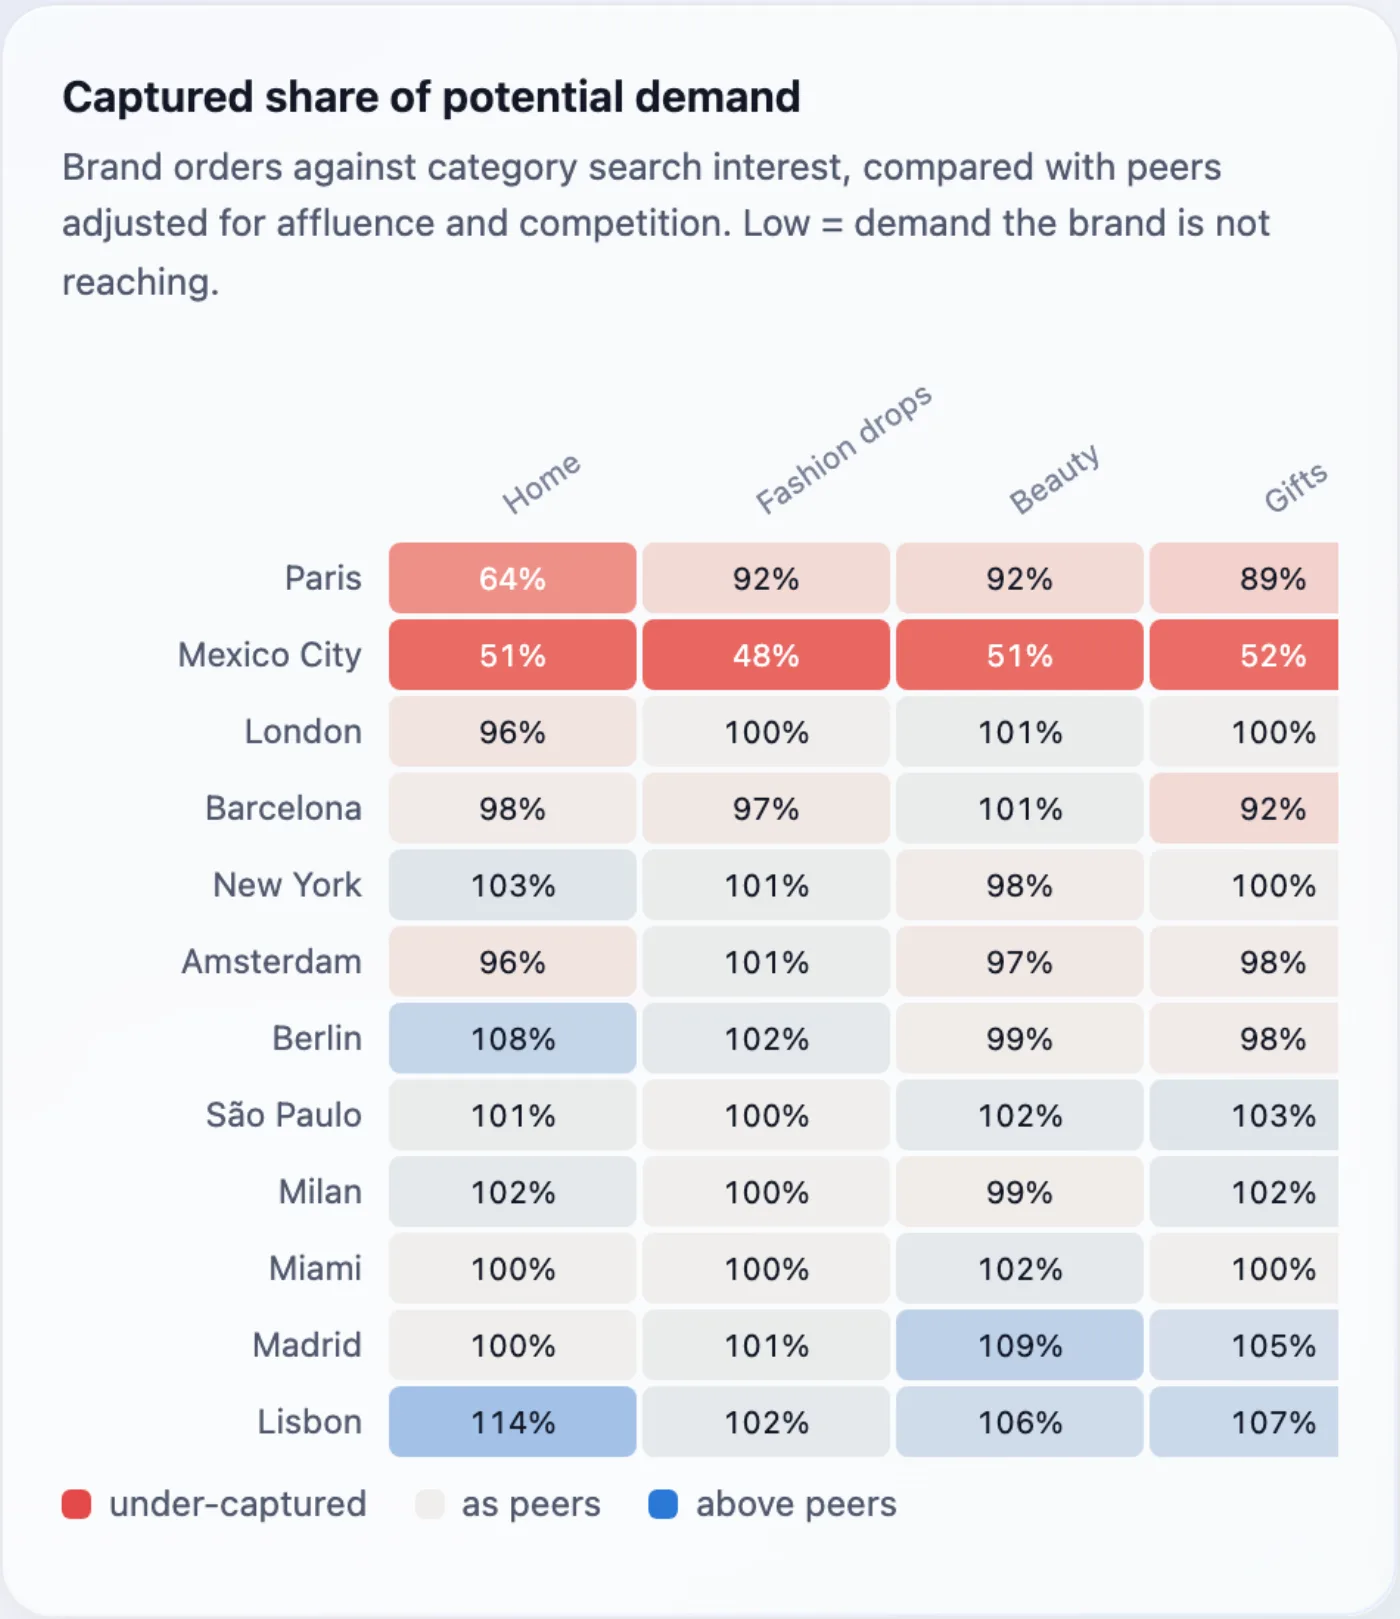
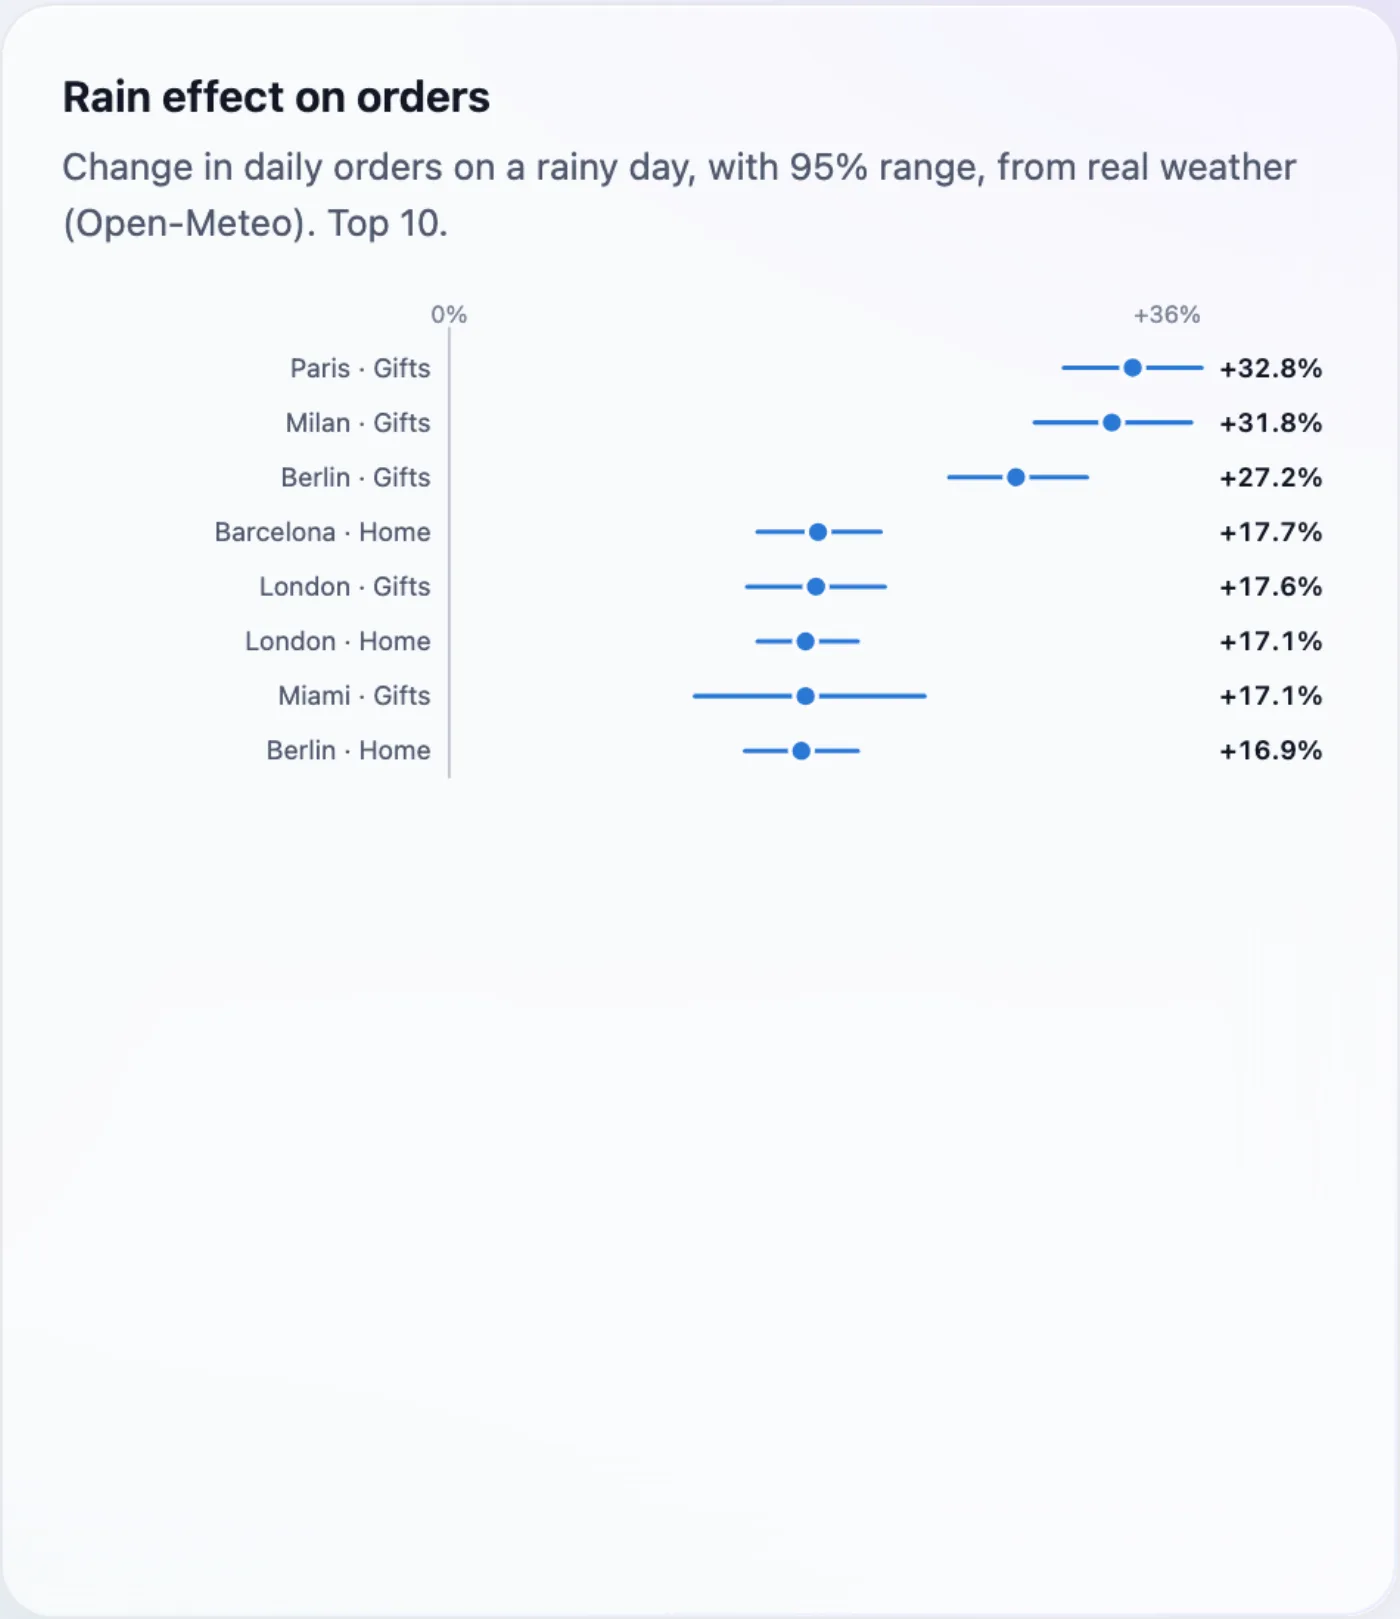
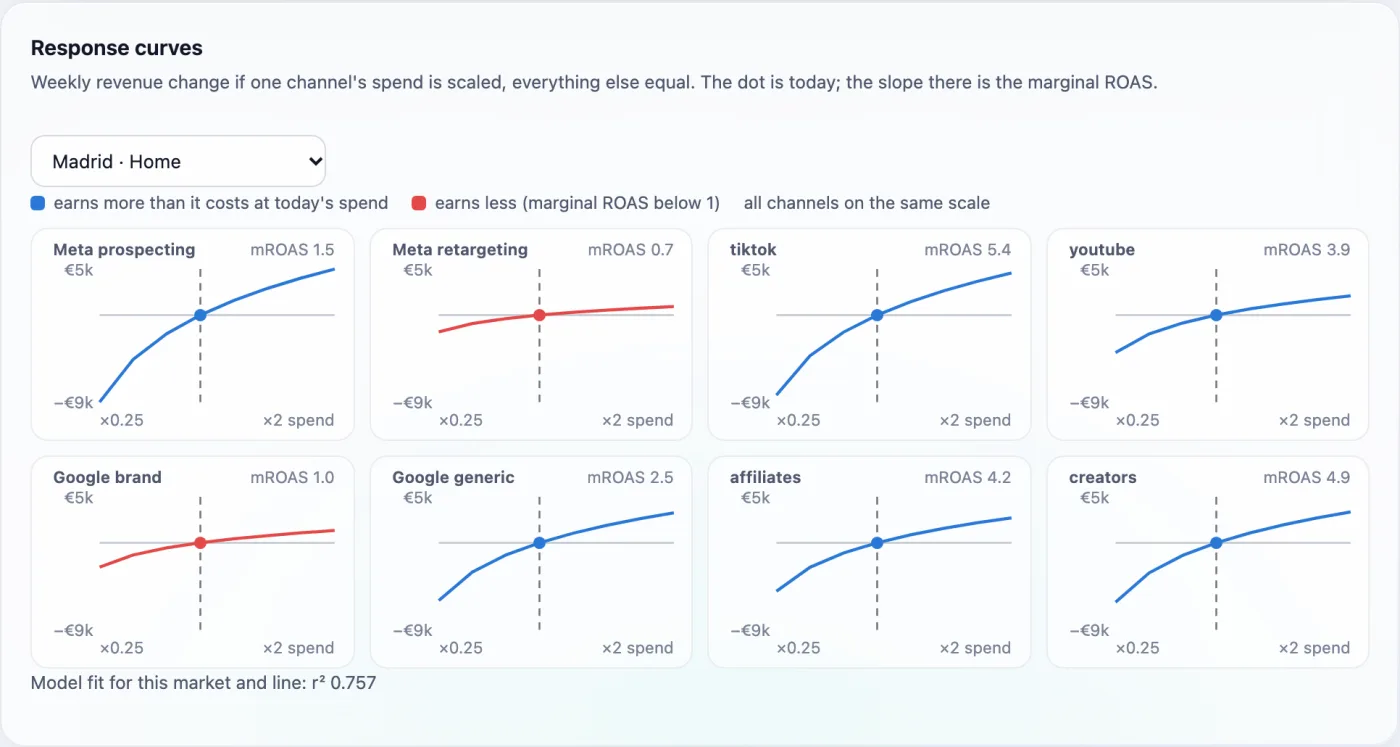
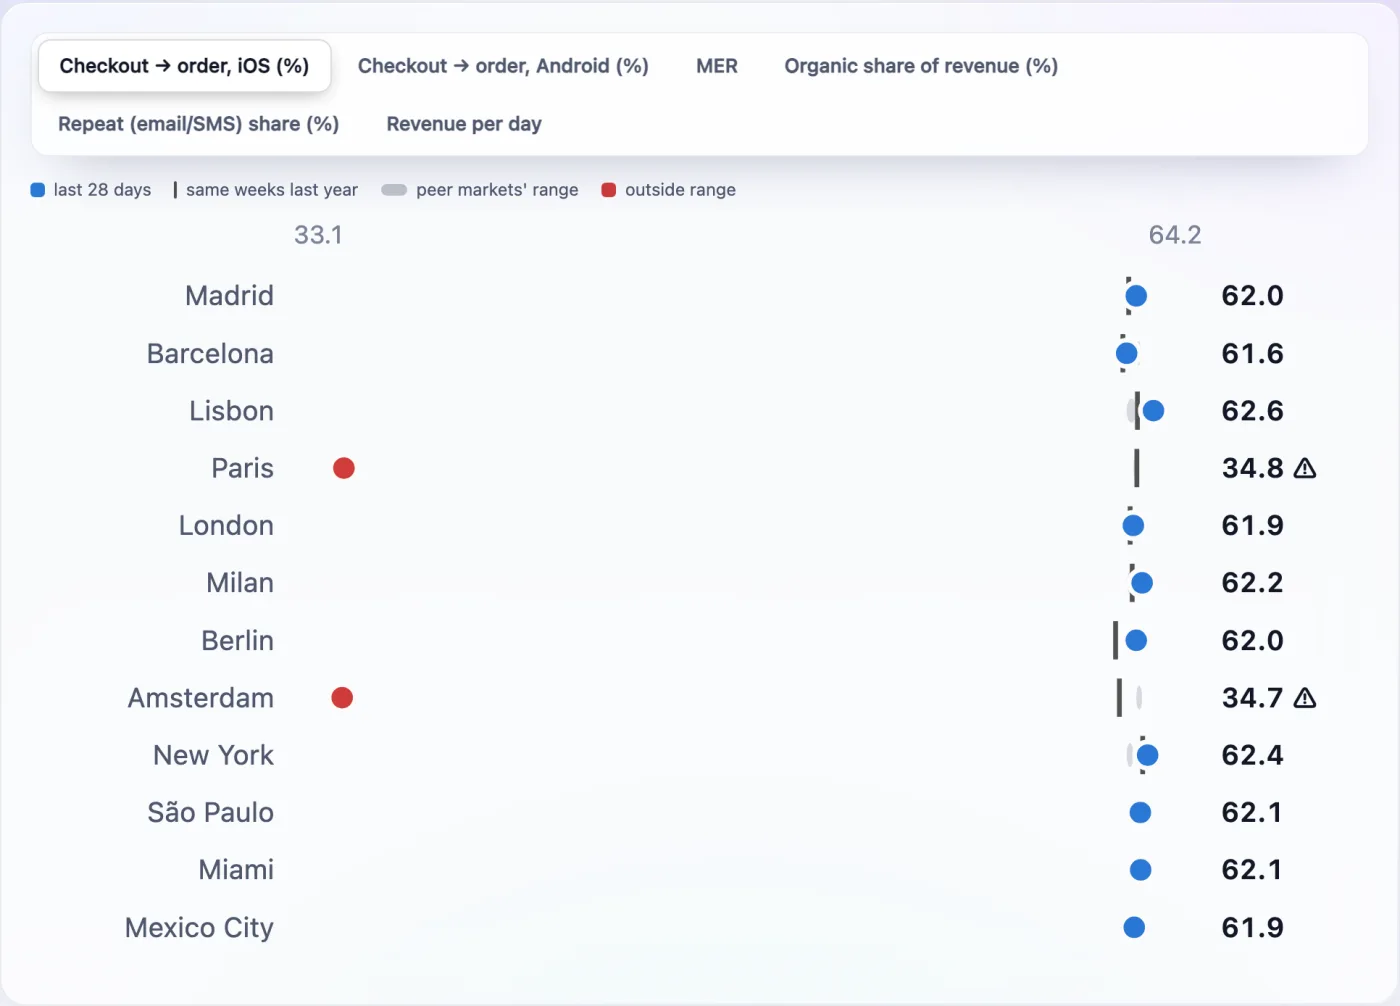
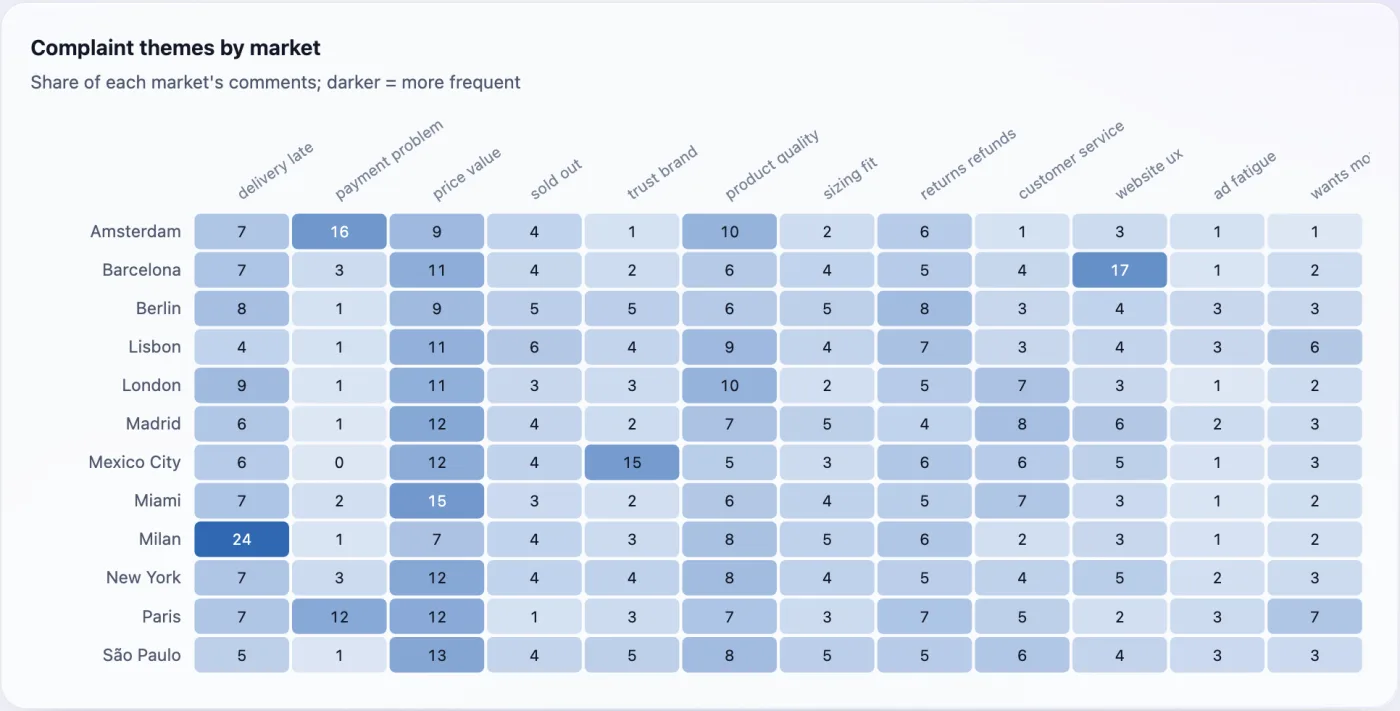
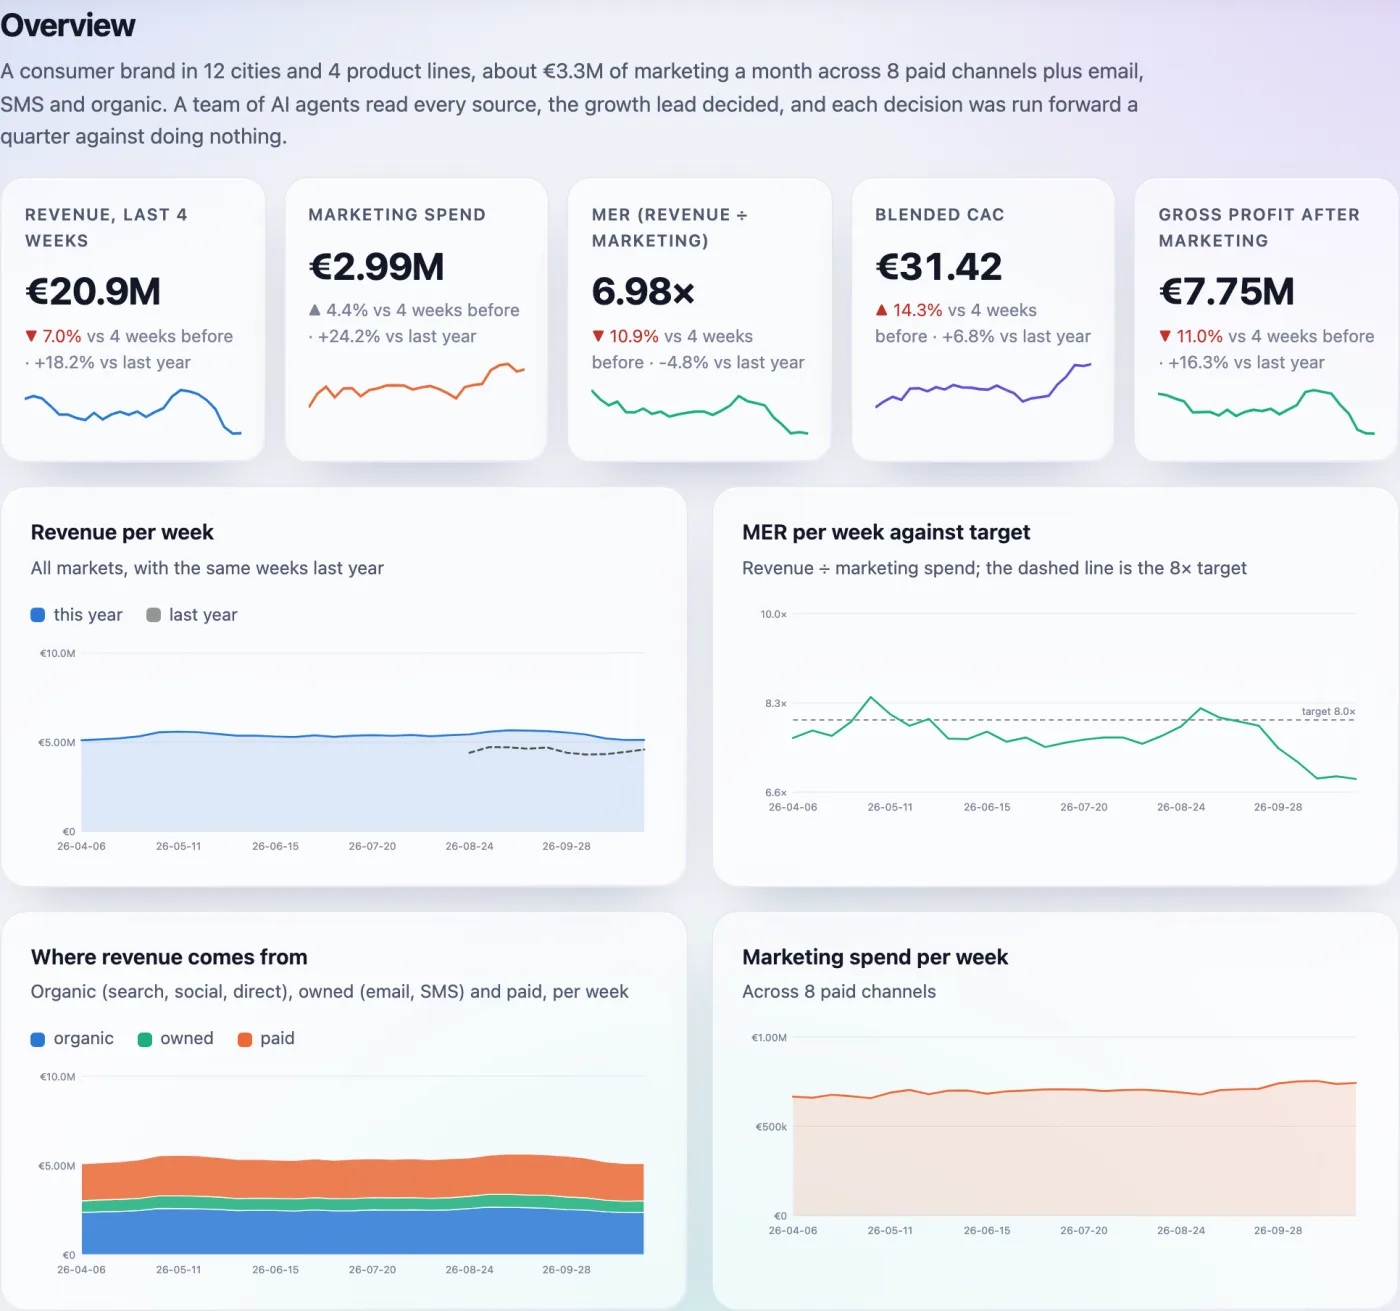
Pantallas de la consola en vivo, sobre el negocio sintético.
En qué se equivoca
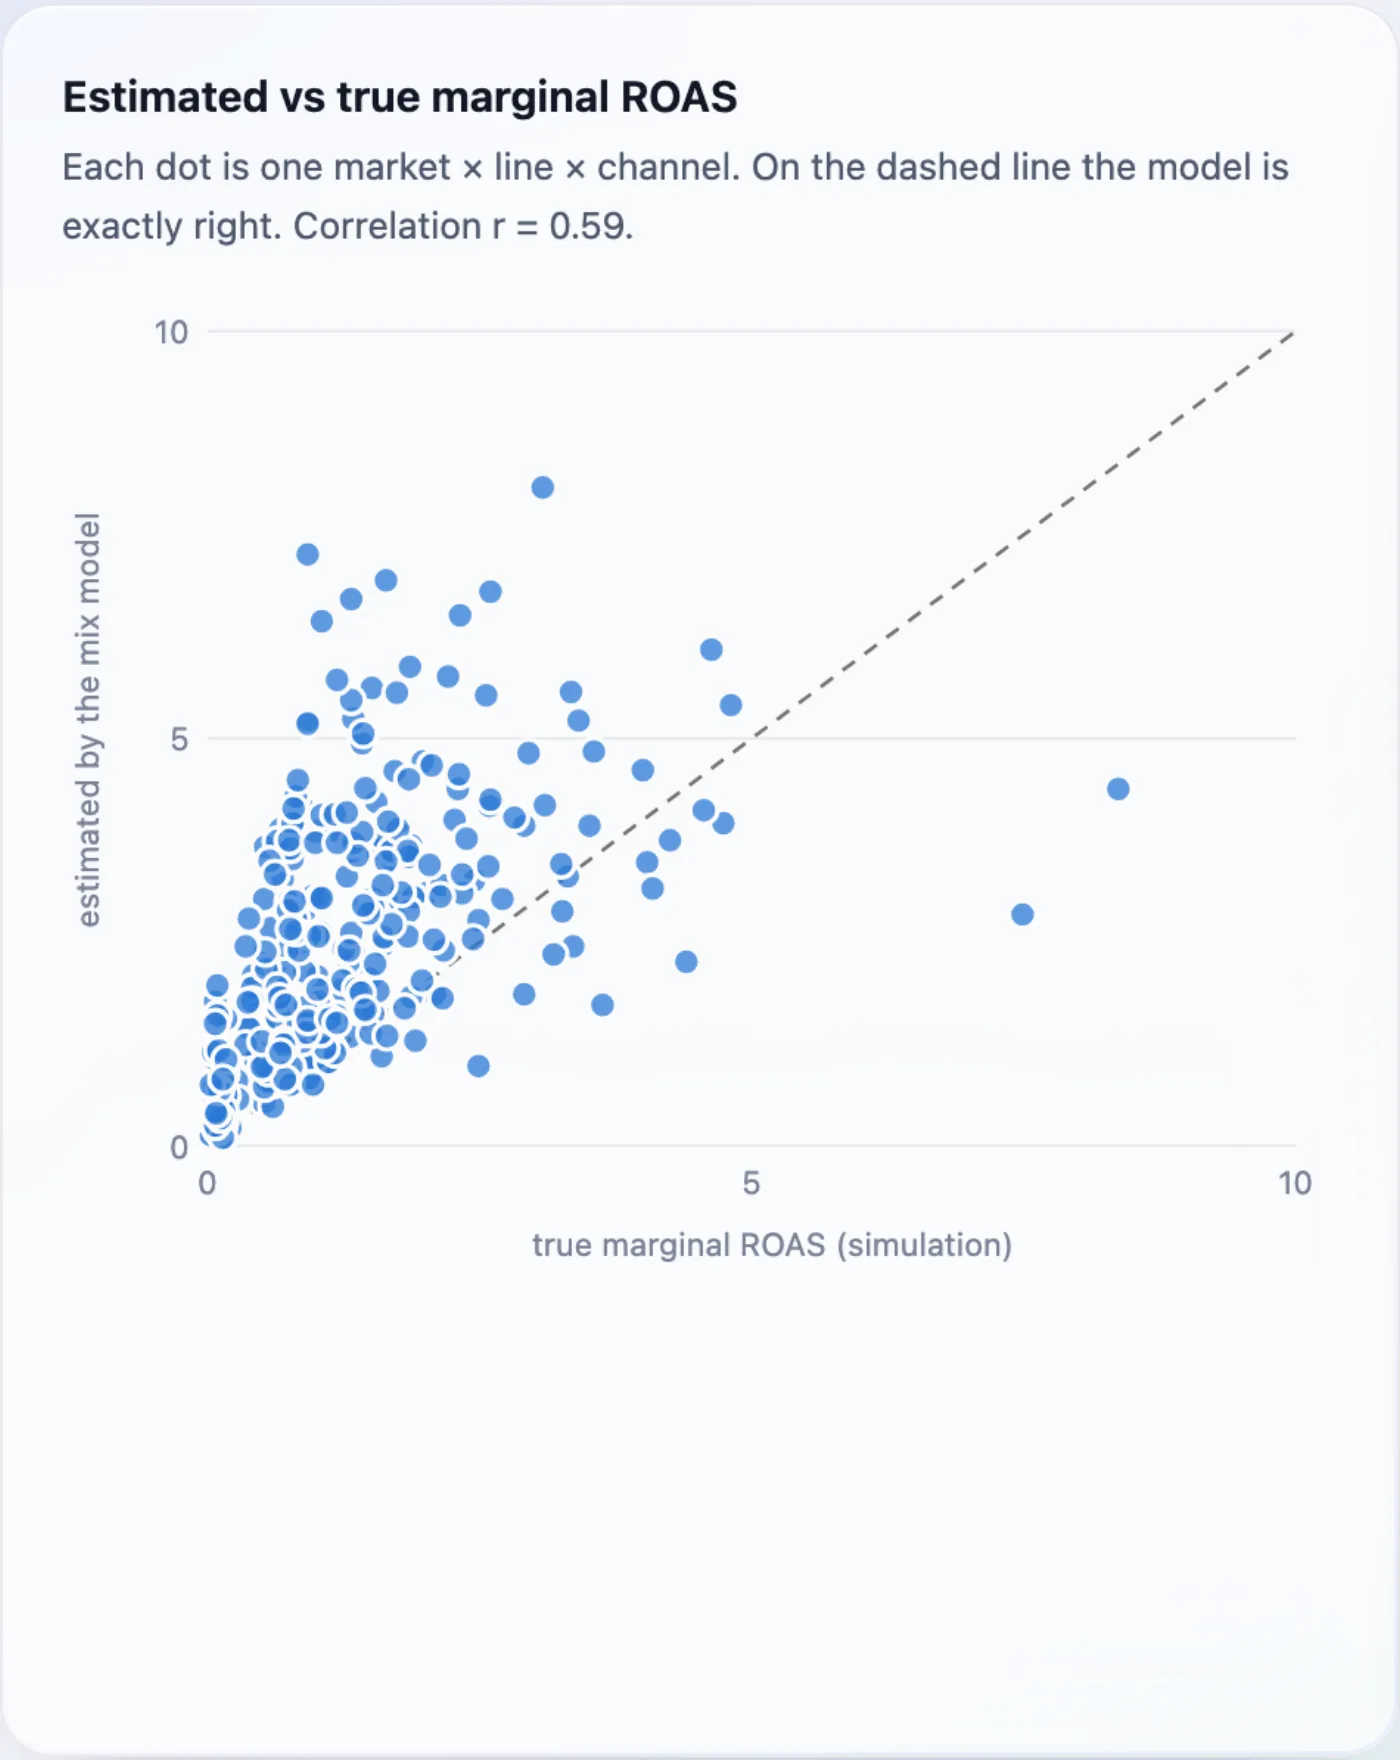
La consola enseña el modelo frente a la verdad oculta de la simulación, algo que solo una simulación permite.
- El modelo de marketing mix sobreestima los rendimientos marginales (correlación 0,59 con la verdad) y no detecta bien la saturación de Meta prospecting. Los agentes culpan entonces a la búsqueda de marca y al retargeting. El evaluador de IA lo da por fallado en los tres negocios no vistos, y las dos opciones más simples también fallan: el error está en el modelo, no en los agentes. Una persona que revisó las comprobaciones lo dio por bueno.
- Un hueco de demanda real se detectó pero se descartó por antiguo en dos de tres.
- Una caída del tráfico de búsqueda tapada con más gasto de pago no se relacionó con su causa en dos de tres.
- Una vez, el responsable recortó el presupuesto de una línea con un modelo que ajustaba mal, en un mercado que solo tenía ruido.
- El evaluador de IA coincide con una persona en 37 de 45 comprobaciones (kappa de Cohen 0,24): más estricto en seis y más indulgente en dos. Cada comprobación por separado es incierta; los totales valen con un margen de unas pocas.
Cómo escala
- El hub es un esquema, no un producto: las mismas tablas en BigQuery, Snowflake o Postgres, un conector por fuente. Incluye conectores para Mixpanel, Microsoft Clarity y Hotjar, probados con respuestas de ejemplo.
- Una ejecución semanal para toda la cartera cuesta unos 2,50 $, con un tope de coste por ejecución; una por región funciona igual.
- La autonomía crece un tipo de acción cada vez, solo donde el registro demuestra que las aprobaciones acertaban.
- Despliegue en cuatro fases con criterios de salida: conciliar cifras, en sombra, asistido y a escala.
Evidencia más allá de la simulación
- Datos públicos reales: el embudo y 3.000 reseñas de un marketplace online; un dataset público de anuncios de Facebook donde una audiencia se llevó el 20 % del gasto a 4,5 veces el coste por comprador, y 207 anuncios sin gasto aparecían con 76 compradores.
- El agente analista por sí solo superó 68/70 y 58/60 comprobaciones en negocios que nunca había visto.
Tecnología
- Python 3.12
- Claude Opus 5.5 (agentes)
- Claude Haiku 5.5 (Batch API)
- Servidor MCP
- Hub SQLite, portable a un data warehouse
- Modelo de marketing mix (log-log, agrupado con contracción)
- Aprobaciones en Slack (endpoint firmado)
- Tiempo de Open-Meteo
- Festivos de Nager.Date
- Panel SVG estático, sin librerías
- pytest y node:test (63 tests)
El negocio es sintético y todos los resultados son simulados, con los supuestos visibles en la consola. Datos reales: tiempo de Open-Meteo (CC BY 4.0), festivos de Nager.Date, datasets públicos de Kaggle (CC BY-NC-SA 4.0). Las poblaciones metropolitanas redondeadas son cifras públicas usadas solo como tamaño. Claude es el modelo utilizado; es un proyecto independiente, no respaldado ni patrocinado por Anthropic.
Siguiente proyectoSpain Open Data