Location Intelligence
Elegir local para un restaurante con números, no con intuición
Resumen
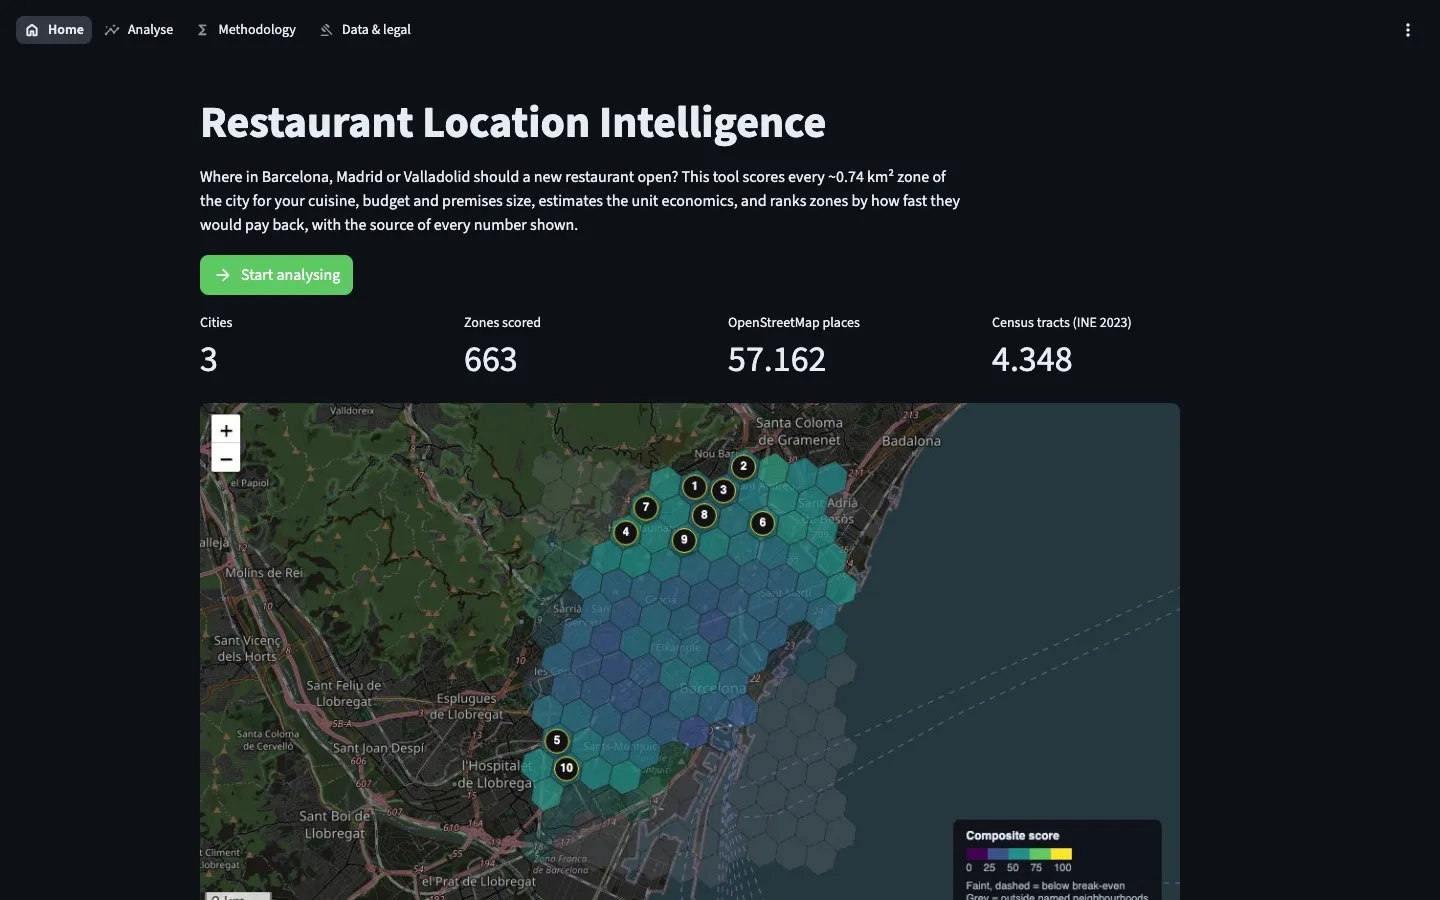
Una herramienta que ordena cada pequeña zona de una ciudad según la rentabilidad de un restaurante, y muestra de dónde viene cada dato.
El problema
Elegir local es la decisión más cara de un restaurante independiente, y suele tomarse por intuición y con la presentación de un agente. Un mal contrato de alquiler puede hundir una buena cocina.
El enfoque
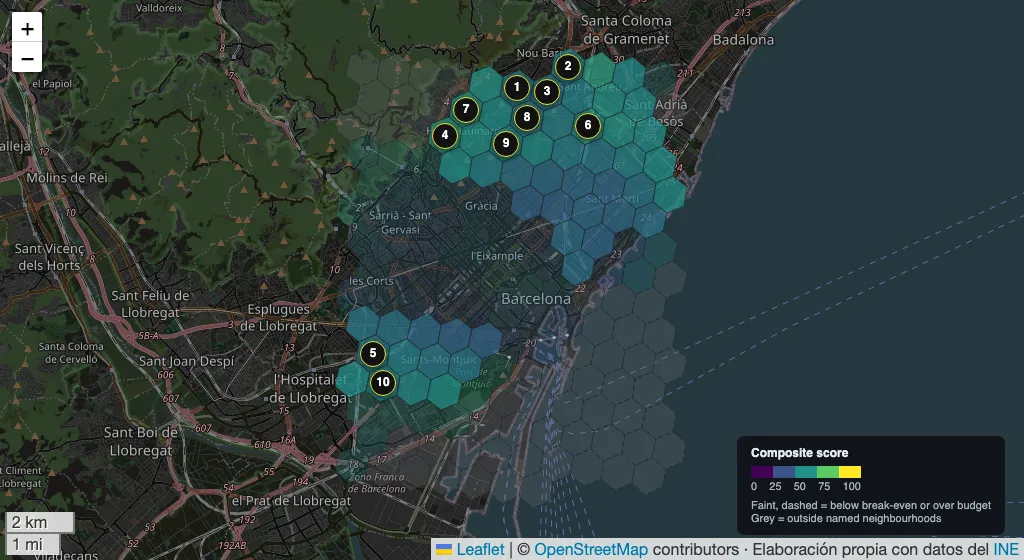
- Cada ciudad se divide en zonas hexagonales de unos 0,74 km². Para cada una se estima la demanda de residentes y visitantes, descontando la competencia de la misma cocina y limitada por el aforo.
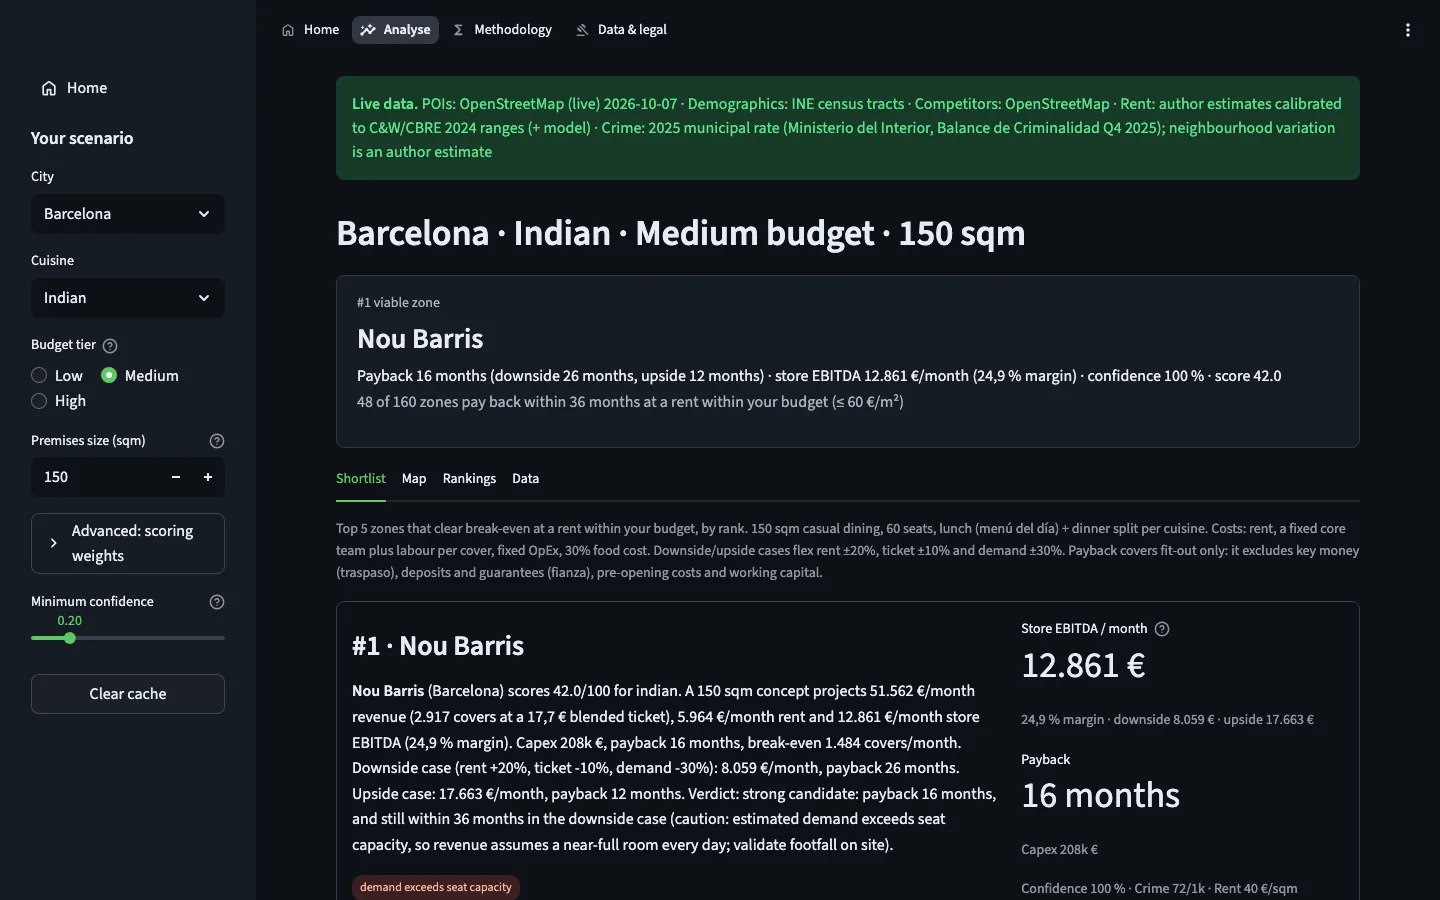
- Rentabilidad completa por zona: ingresos, alquiler, personal, coste de comida, EBITDA, punto de equilibrio y retorno, con un escenario pesimista y otro optimista.
- Ocho indicadores, del hueco competitivo al tráfico peatonal (estimado a partir de comercios, oficinas y transporte) y el nivel de renta, combinados en una puntuación con pesos ajustables.
- Primero, la procedencia: lo primero que se ve es de dónde vienen los datos. La demografía y la competencia son datos reales; el alquiler aún es una estimación a partir de rangos públicos de consultoras, así que cada veredicto lo indica y el escenario pesimista suma un 20 % al alquiler.
Qué construí
Elige ciudad, cocina, presupuesto y tamaño de local. Obtén una lista priorizada, con la rentabilidad primero, un mapa, fichas de cada zona y datos exportables, para Barcelona, Madrid y Valladolid.
Límites
El modelo de demanda aún no está calibrado con aperturas y cierres reales. Usa la lista como el sitio donde mirar a pie de calle, no donde firmar.
Así funciona
Grabado en la demo en vivo. Las cifras son estimaciones del modelo con datos abiertos.
Decisiones
Tres decisiones que dieron forma a este proyecto, y por qué las tomé.
-
La rentabilidad decide el orden; la puntuación solo colorea el mapa
- Contexto
- Una puntuación ponderada de ocho señales es fácil de construir, y fácil de ajustar hasta que dice lo que querías oír. A quien abre un restaurante le importa una cosa: si el local se va a pagar.
- Decisión
- El orden sale de la rentabilidad: primero las zonas viables, ordenadas por plazo de retorno, y la puntuación compuesta colorea el mapa y deshace empates.
- Por qué
- Las dos vistas son independientes, así que la puntuación no puede inflar los ingresos. El mismo orden aparece en el mapa, en la tabla y en cada ficha: una sola respuesta, no tres.
-
Cada veredicto dice en qué se apoya
- Contexto
- Algunos datos recurren a estimaciones o a datos sintéticos. Sin datos censales por sección, todas las zonas de una ciudad comparten la misma demanda de residentes.
- Decisión
- Lo primero que se ve es de dónde vienen los datos. El veredicto de sí o no necesita la demografía por sección censal del INE y la competencia de OpenStreetMap en vivo; el alquiler aún es una estimación, y cada veredicto lo indica.
- Por qué
- Sin demografía por sección, todas las zonas comparten la misma demanda, así que no se muestra veredicto. Con ella, la lista merece una visita, y el alquiler estimado aparece señalado junto a cada plazo de retorno.
-
Primero datos abiertos, y nada de scraping
- Contexto
- Los portales inmobiliarios y Google Places darían más detalle sobre alquileres y competencia, pero los portales prohíben el scraping, la ley española protege sus bases de datos y las condiciones de Google limitan cómo se muestran y se guardan los datos de Places.
- Decisión
- La herramienta pública funciona con OpenStreetMap y datos del INE; Places es opcional y privado, y la CI lo rechaza si entra en el repositorio; los alquileres llegan por un importador para datos con licencia.
- Por qué
- La demo tiene que ser legal y poder compartirse. Con el importador listo, tener mejores datos de alquiler es una decisión de compra, no una reconstrucción.